
2026 年 10 月 13 日,谷歌宣布 Gemini 4 Argon 全面开放(9 月 30 日已先向网络安全合作方推出)。官方 19 项对比中它领先 13 项,但数据混合了自测与公开榜单。截至 10 月 18 日查询,它在 LMArena 文本榜和 Vals Index 居首,在 Artificial Analysis 智能指数 v4.3.2 排第 8。
Gemini 4 Argon 与三组榜单柱状图的抽象画面,柱高不代表任何真实数据。AI 生成示意图,非官方图片。
发布时间线、开放范围与费用
Google 博客 2026 年 9 月 30 日的文章首次宣布 Gemini 4 Argon,当时只通过 Fairwind 计划向一批受信任的网络安全防御方开放,并表示会在加强防护后再面向开发者、企业和普通用户。10 月 13 日,Google DeepMind 高级副总裁 Koray Kavukcuoglu 署名的博客宣布 Argon 全球可用:开发者和企业可通过 AI Studio 与 Gemini 平台的 API 调用,Google AI Ultra 订阅用户可在 Google Antigravity 中使用,Ultra 与 Pro 订阅用户可在 Gemini 应用和搜索的 AI 模式中使用。同日发布的模型卡写明,Argon 采用稀疏混合专家(MoE)架构,输入与输出合计上限 100 万 token,知识截止时间为 2026 年 3 月。Vals AI 与 Artificial Analysis 的模型页把发布日期记为 9 月 30 日,对应的是首次宣布和有限开放,而不是全面开放。
费用方面,API 首发优惠价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入按输入价的 5% 计(官方表述为优惠 95%);优惠期于 2026 年 11 月 30 日结束,之后按每百万输入 token 4 美元、输出 token 20 美元收费,该价格仅适用于面向公众的 Argon 模型。科研权益方面,Google 向 1 万名科学家提供 6 个月免费的 Antigravity 最高使用档,滚动入组,需符合资格并视容量与遴选而定;申请截止日期和适用地区原文未写明,待核对。网络安全防御方可申请加入 Fairwind 计划,获得不带网络安全护栏的 Argon,同样滚动开放,资格条件待核对。博客称 Argon“全球推出”,但 Gemini 应用与 AI 模式订阅在各国家和地区的实际可用性未列明,待核对。
厂商自报:模型卡 19 项成绩及其口径
Google 在模型卡中给出 19 行对比(标注为截至 2026 年 10 月的结果),对手是 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。逐行统计,Argon 领先 13 行;在 CWE-bench v1 上与 GPT-6 Astra 同为 68.0%;在 5 行落后:FrontierSWE v2(55.0%,最高为 GPT-6 Astra 的 65.5%)、Terminal-bench 4.0(57.4%,最高为 Claude Opus 5.5 的 66.4%)、PostTrainBench(45.3%,最高 49.3%)、Terminal-Bench Science 0.1(57.6%,最高 68.1%)和 OSWorld-2.0 离线子集(69.2%,最高 72.6%)。领先幅度较大的有 Harvey 法律智能体基准(19.6%,次高 6.7%)、AutomationBench(51.3%,次高 42.5%)和 GraphWalks 256k–1M 长上下文(84.2%,次高 71.8%)。
按 Google 评测方法页的说明,这 19 行的数据来源并不统一。Vals Index、AutomationBench、Vals Finance Agent v2、Harvey 法律智能体基准、FrontierSWE、Vibe Code Bench、RiemannBench、Chartography 和 CWE-bench v1 共 9 行取自公开榜单;PostTrainBench、LABBench 2、GraphWalks 两档和 LVBench 共 5 行由 Google 为所有模型统一自测;DeepSWE v1.1、Terminal-bench 4.0、Terminal-Bench Science 0.1、Agent's Last Exam 和 OSWorld-2.0 共 5 行是 Google 自测的 Argon 分数,配上来自公开榜单、系统卡或官方博客的对手分数。Argon 的 5 项落后中,有 3 项出现在最后这类混合口径中。
方法页还写明了几处会影响比较的设置:Argon 一律使用 Gemini API 的最高思考档,对手默认取各自可用的最高推理档,比较的是能力上限,而非默认设置下的表现或成本;OSWorld-2.0 的 Argon 分数取 3 次运行中的最高值;LVBench 中 Gemini 按每秒 1 帧采样,GPT-6 Astra、Fable 5.1、Opus 5.5 因 API 限制分别输入 800、300、600 帧,各模型看到的视频并不相同。发布博客另给出 ERQA 具身推理 87%、Gray Swan 间接提示注入攻击成功率 0.7%,以及 Gamow Labs 私有评测中的 RareBench 57%、LabBench 52.2%;后两项基于私有临床与实验数据,外部无法复现。博客里的 LabBench(52.2%)与模型卡的 LABBench 2(88.8%)不是同一套评测,不能直接对比。
第三方榜单:LMArena、Vals Index 与 Artificial Analysis
LMArena 的文本竞技场(arena.ai)根据用户匿名盲测投票为模型打分。本文于 2026 年 10 月 18 日读取其文本总榜,页面标注日期为 2026 年 10 月 8 日,累计 8,734,330 票、414 个模型:gemini-4-argon-high 以 1525±9 分排第 1,排名区间为 1–1,并标有“Preliminary”(初步);第 2 名 claude-opus-5.5-high 为 1507±8 分。Argon 的票数只有 4,892,远少于榜单前列多数模型的数万票,评分仍可能变动。页面日期早于 10 月 13 日全面开放,这一日期的含义以及该视图采用的方法版本,页面均未说明,待核对。
Vals AI 的 Vals Index 衡量模型作为智能体在金融、编程、法律和税务任务上的表现,并按各行业在美国 GDP 中的占比加权。榜单页标注 2026 年 10 月 16 日更新,Argon 以 68.90% 排第 1,其后为 Claude Sonnet 5.5(67.04%)和 Claude Opus 5.5(66.97%)。Vals 称评测使用 high 推理档、温度 1.0,每次测试成本 15.68 美元按每百万 token 4/20 美元的标准价计算。Google 所说的“Vals Index 第 1”引用的正是这份榜单,属于第三方测得、厂商引用的结果。同一机构的数据也显示出 Google 表格之外的差异:Vibe Code Bench 上 Argon(91.91%)排在未列入 Google 对比表的 Claude Sonnet 5.5(92.39%)之后;Terminal-Bench 4.0 上 Argon 为 57.58%,排第 5。Vals Index 的方法版本号页面未标注,待核对。
Artificial Analysis 的模型页(2026 年 10 月 18 日查询)显示,Gemini 4 Argon(High)在智能指数 v4.3.2 上得 53 分,在其比较组 217 个模型中排第 8。该指数综合 10 项评测:AA-Briefcase v1.1、GDPval-AA v2.1、AutomationBench-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、GDP.pdf、CritPt、AA-Omniscience 和 AA-LCR v1.1。Artificial Analysis 在 9 月 30 日的文章中称,High 是 Argon 当时可用的最高推理档,其 53 分与 GPT-6 Astra(max)持平。模型页的输出速度一栏为 N/A,成本按每百万 token 2/10 美元的首发价计算。
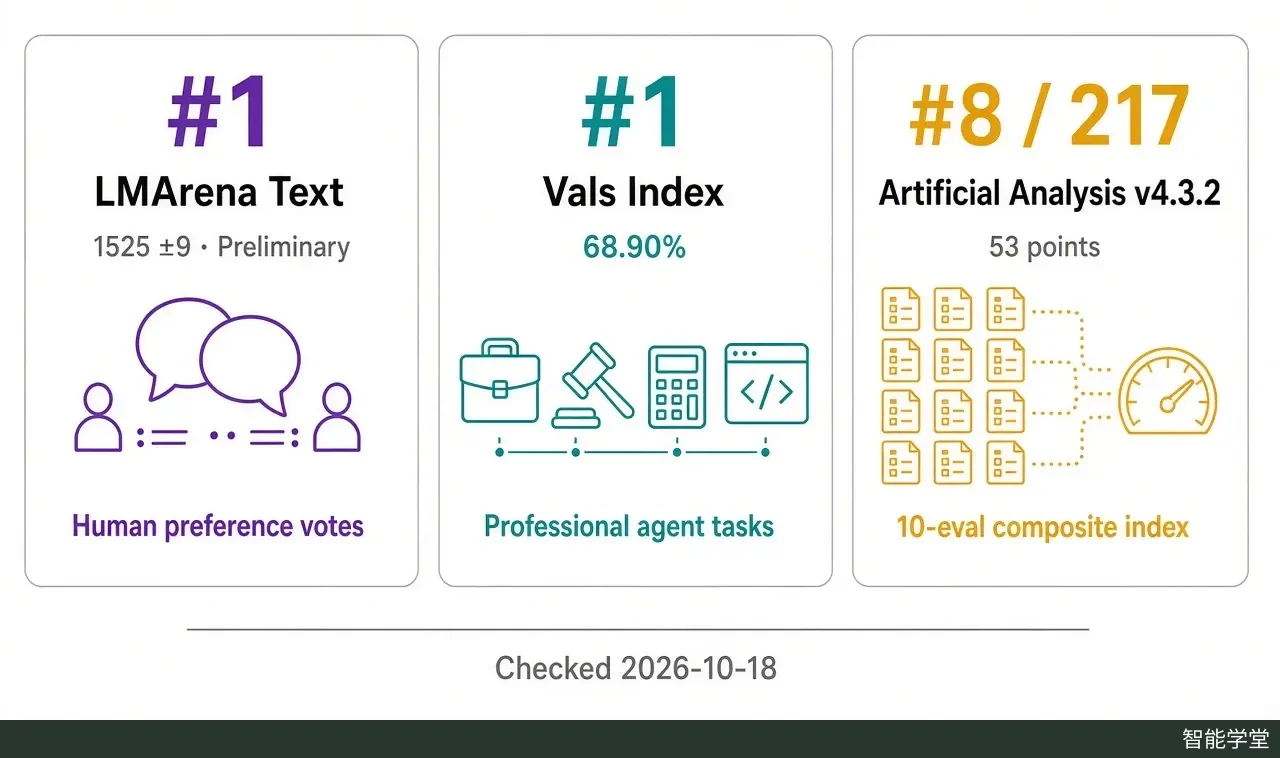
Gemini 4 Argon 在三家第三方榜单中的名次:LMArena 文本总榜第 1(1525±9,Preliminary,页面日期 2026-10-08,方法版本待核对);Vals Index 第 1(68.90%,2026-10-16 更新,方法版本待核对);Artificial Analysis 智能指数 v4.3.2 第 8/217(53 分)。数据来源:LMArena、Vals AI、Artificial Analysis,查询日期 2026-10-18。AI 生成示意图,第三栏评测图标数量仅作示意。
榜单方法差异与局限
几份榜单给出不同位置,主要是因为测的东西不同。LMArena 反映用户在开放式对话中的偏好,受回答风格和提问人群影响,不直接衡量长时间运行的智能体任务;Vals Index 聚焦有经济价值的专业任务并带有美国 GDP 权重,换一套行业权重,名次可能改变;Artificial Analysis 的综合指数由它选定的 10 项评测合成,Argon 的“第 8”只是 High 档这一配置的结果,模型页上 SciCode 和 CritPt 两项还标注为“Under review”。Google 模型卡则只选了 3 个对手和 19 项基准,并按最高推理档比较。
阅读这些数字时,可以把 Google 的表格看作厂商选题、部分自测的成绩单,把 LMArena 和 Vals Index 的第 1 看作两种不同口径下的第三方结果,把 Artificial Analysis 的第 8 看作综合指数下的另一个参照。它们都只是查询当天的快照:Argon 在 LMArena 仍是初步评分,Artificial Analysis 尚无速度数据,11 月 30 日优惠价到期后,按价格计算的成本类指标也会变化。用于实际选型时,仍需用自己的任务做小规模对照测试。