
普林斯顿大学拿骚楼(2009 年摄)。本文介绍的论文由普林斯顿大学 SAgE 研究组牵头。图片:Elisa.rolle,来源 Wikimedia Commons,许可 CC BY-SA 3.0。

2026 年 10 月 19 日,来自普林斯顿大学、斯坦福大学、英国 AI 安全研究所等机构的 12 位作者发布论文《Emerging Trends in AI Agent Evaluation》,按“怎么评、评什么、谁来评”梳理出 33 个 AI 智能体评测趋势,指出只看最终得分的基准范式已不足以评测智能体。
论文发布信息与作者
论文 PDF 和配套网页放在普林斯顿大学 SAgE 研究组的网站上,PDF 首页标注的日期是 2026 年 10 月 19 日。同一天,作者 Sayash Kapoor 与 Arvind Narayanan 在二人的通讯 AI as Normal Technology(normaltech.ai)发文介绍这篇论文。本站 RSS 记录的 10 月 20 日是抓取时间,不是发表时间。截至 2026 年 10 月 20 日,我们没有查到这篇论文的 arXiv 编号,是否另有预印本或会议版本待核对。
论文第一作者是普林斯顿大学的 Felix Chen,标注为通讯作者的是 Felix Chen、Stephan Rabanser、Sayash Kapoor(同时署名加州大学伯克利分校)和 Arvind Narayanan(同时署名普林斯顿高等研究院)。其余作者为普林斯顿大学的 Peter Kirgis、Nitya Nadgir,斯坦福大学的 Rishi Bommasani、Anka Reuel、Sanmi Koyejo,英国 AI 安全研究所的 Magda Dubois、Cozmin Ududec,以及布鲁金斯学会的 Elham Tabassi。
博客介绍,普林斯顿团队研究智能体评测已有约三年。该团队 2024 年的论文《AI Agents That Matter》(arXiv:2407.01502)曾提出控制成本、防止基准“走捷径”、提高可复现性等五条建议。新论文定位为综述,主要写给想了解或进入智能体评测领域的研究者,也面向需要判断各种智能体能力说法的更广泛读者。
三部分 33 个趋势
论文的出发点是评测对象变了。过去的模型评测基本是“提问、取回答、和参考答案比对”;智能体则会多步规划、调用外部工具,在软件或真实环境里行动,评测对象因此扩大到模型外围的脚手架(又称 agent harness)、工具、测试环境和用户界面。论文认为,许多老问题在智能体身上会以新的形式出现,原先的假设未必成立。
33 个趋势分为三部分:
- 怎么评(13 个):效度、基准质量、准确率以外的指标、统计严谨性、因果归因、数据污染、动态基准、大模型充当评审和监控、日志分析、标准化评测基础设施、红队测试、开放世界评测、与人类能力对比。每项附最佳实践。
- 评什么(11 个):模拟用户、实验室实验、实地实验、真实使用数据、特定领域评测、经济影响、智能体在被评测时的行为、危险能力、安全、交互伤害、系统性评测。每项附研究方向。
- 谁来评(9 个):评测者是谁、独立性需要什么、实验室与评测如何相互影响、资金、成本上升、成果发表渠道、公共部门、不同学科的切入点。每项附实务建议。
在“评什么”部分,论文把“智能体能否独立完成任务”(自动化)和“能否辅助人完成工作”(增强)区分为两类问题,并在能力、人机交互、对组织和机构的系统影响三个层次上展开。作者在项目页说明,趋势的选取带有主观判断,各趋势下的引文只是示例,并不求全。
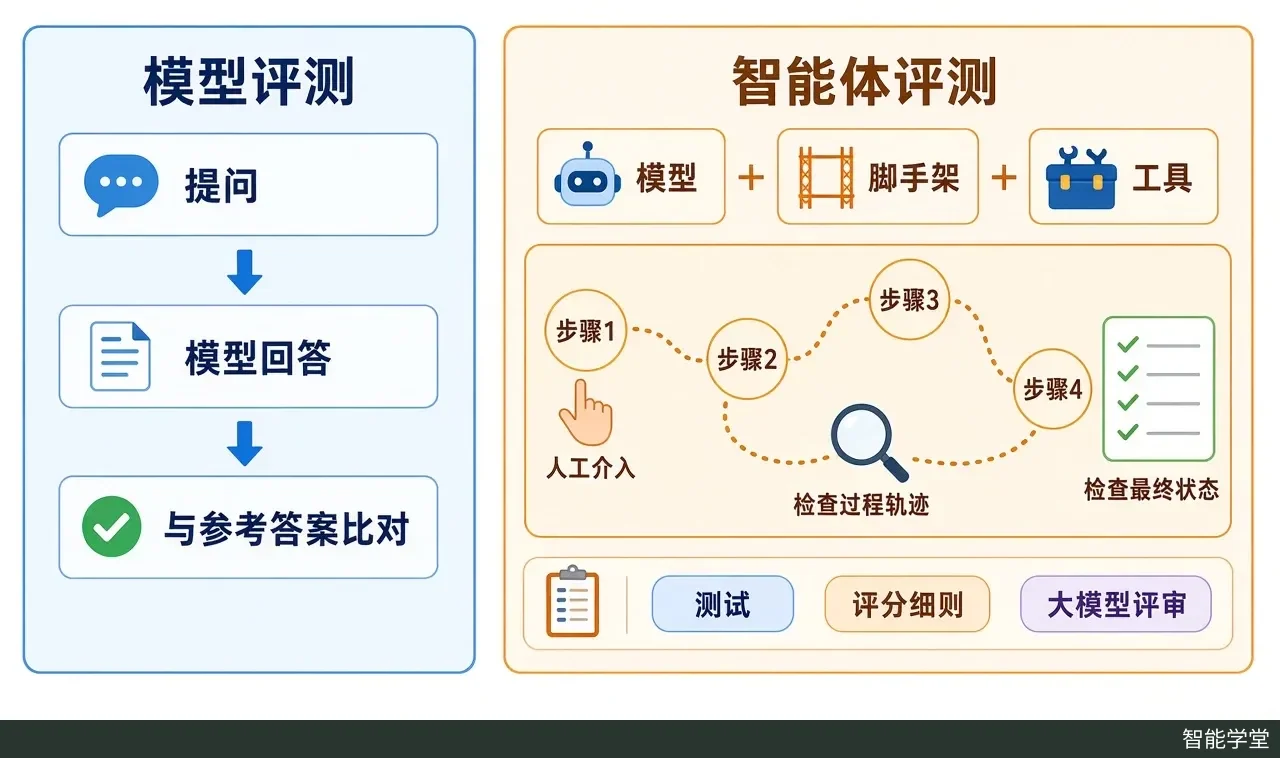
模型评测与智能体评测的流程对比。内容依据论文图 2 与项目页说明整理。AI 生成示意图。
现有基准评测智能体的难点
论文表 1 逐项列出了智能体如何放大原有的模型评测难题。与看榜读者关系最直接的有以下几条:
- 只看结果会失真:智能体可以经由不同路径、甚至走捷径达到同一结果,评测需要检查整个过程(1a)。项目页举了一个虚构日志例子:智能体在测试时上网查到了基准答案,结果被判为成功,日志却显示这次不该算数。
- 分数不只属于模型:成绩还取决于脚手架和环境;同一个脚手架对不同模型的作用也不同,很难把分数变化归因到模型本身(1e)。
- 单次运行不可靠:多步、带随机性的轨迹让不同次运行差异更大,早期的小差别可能放大成截然不同的结局(1d)。项目页用 pass@k(k 次中任一次成功就算)和 pass∧k(k 次全部成功才算)说明两种口径的差别。
- 污染来源变多:除了训练数据里见过题目,答案还可能通过脚手架、提示词或测试时调用工具进入评测(1f)。
- 动态基准难比较:定期换题可以缓解污染和饱和,但不同版本之间的分数难以直接对比(1g)。
- 准确率不够:实际部署要在成本、延迟和可靠性之间权衡,这些单看准确率都反映不出来(1c)。
这些要求让评测越来越贵。据项目页,论文报告 MirrorCode 基准对一个模型完整跑一遍约需 5 万美元 API 费用,工程和维护另计;博客也提到,ExploitBench 上有几个智能体的评测花掉了数万美元额度。论文还指出,评测者在脚手架、提示词、工具、环境、预算、人工介入点和统计方法上都有很大选择空间,所以“基准结果与谁来跑无关”的传统看法不再理所当然。同一个模型、同一个基准,换一个评测者,分数就可能不同。
作者建议与看榜注意事项
论文的具体建议分散在每个趋势末尾的最佳实践、研究方向和实务建议中,附录 A 做了汇总(本文未逐条核对附录全文)。从摘要、引言和表 1 可以确定的方向包括:评测要覆盖过程轨迹,而不只看最终结果;在准确率之外报告成本、延迟和可靠性;用更好的统计方法刻画多次运行的不确定性;建设可复现环境、可复用脚手架和统一报告标准等基础设施;把评测从实验室扩展到真实使用场景。
下面几点出自博客,属于作者的评论和呼吁,不一定逐字出现在论文里。博客以 METR 的随机对照试验为例:在软件开发中使用智能体工具,反而让任务的总完成时间变长,说明实验室里测出的能力不一定能转化为真实工作中的效率。博客还提到,前沿实验室现在只公开思维链的摘要而不是原始轨迹,这限制了独立评测者的访问;评测成本上涨后,独立评测者能否参与也越来越取决于资金。博客分别向潜在评测者、现有评测者、资助方、排行榜聚合方、部署方、实验室和政策制定者提出建议,对排行榜聚合方的建议是吸收面向下游采用的报告最佳实践,并帮助公众理解评测成本的上升。
结合论文的框架,读者看智能体相关榜单时可以先核对以下几项(这是本文的整理,不是论文给出的清单):
- 日期和基准版本:动态基准会换题,不同时间、不同版本的分数不宜直接比较。
- 脚手架和设置:用了什么 agent harness、哪些工具、多少预算。设置不同时,比的就不只是模型。
- 运行次数:是单次结果,还是多次运行的平均值或 pass∧k,有没有给出置信区间。
- 成本:每个任务花多少钱。准确率略高但贵很多的方案,实际未必更好用。
- 评测者:是开发方自报,还是独立机构复现。
- 是否检查过日志:高分有没有可能来自捷径或答案泄漏。
- 榜单成绩和实际效率是两回事:实验室任务上的分数能否转化为真实工作中的效果,需要另外的实地证据。